LA PARTE UTIL
- Un simulador proporciona un mundo modelado; un proceso de entrenamiento cambia un controlador.
- La inferencia ejecuta una política aprendida y no necesariamente mantiene la formación.
- Mover de la simulación al hardware requiere cheques contra la máquina real.
Sigue un comportamiento de marcha
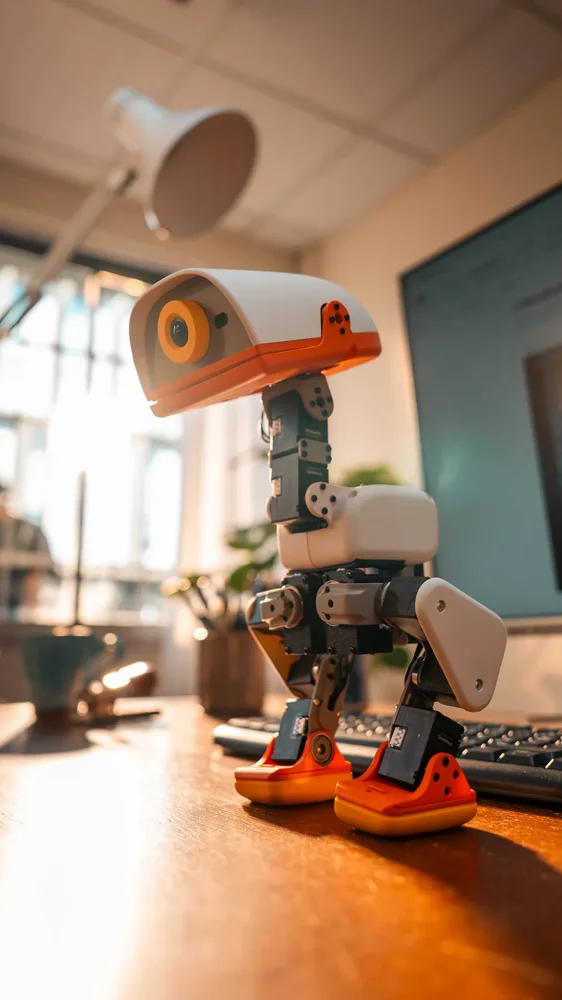
Imagina un robot pequeño que intenta caminar hacia delante sin caerse. Podemos describir su cuerpo, colocarlo sobre un suelo virtual, dejar que un controlador elija las órdenes de los motores y observar el resultado. Esa secuencia contiene varias tareas distintas. El simulador calcula cómo cambia el mundo modelado. Un proceso de entrenamiento puede mejorar el controlador. Más tarde, el controlador en funcionamiento elige acciones a partir de nuevas observaciones. El mismo robot en movimiento puede aparecer en las tres etapas.
Distinguir estas etapas ayuda a entender las demostraciones y a elegir un proyecto. Ejecutar un simulador en tu portátil no significa automáticamente que una IA esté aprendiendo. Ejecutar una política neuronal en un robot tampoco implica que esté cambiando sus propios parámetros. Empieza preguntando qué software se ejecuta, qué recibe y si algo se actualiza como resultado.
La simulación proporciona el entorno
MuJoCo es un motor físico de código abierto utilizado en investigación y desarrollo robótico. Su documentación describe un sistema de cuerpos, articulaciones, contactos y actuadores. A partir de un modelo y unas entradas de control, el motor avanza el estado simulado. En el ejemplo de caminar, estima cómo cambian la postura y el movimiento del robot cuando actúan los motores y los pies tocan el suelo. El resultado depende de las suposiciones y los parámetros del modelo.
La simulación resulta útil incluso con un controlador sencillo programado manualmente. Permite examinar un rango de movimiento, probar una secuencia de órdenes o descubrir que un soporte de cámara bloquea una articulación. La guía de simulación de Reachy Mini muestra cómo crear prototipos de aplicaciones sin hardware. Puede ayudarte a aprender la interfaz de software, mientras que detalles físicos como el sonido real, el recorrido de los cables o la interacción con las superficies requieren una evaluación aparte.
El entrenamiento cambia cómo se eligen las acciones
En el aprendizaje por refuerzo, una política selecciona acciones y un procedimiento de entrenamiento utiliza la experiencia y una señal de recompensa para actualizarla. Al caminar, la recompensa puede favorecer alcanzar la velocidad solicitada y penalizar movimientos no deseados. Una parte difícil consiste en decidir qué observaciones, acciones y recompensas representan la tarea. Un controlador puede cumplir muy bien el objetivo definido y aun así producir un comportamiento que el diseñador no pretendía.
El repositorio de entrenamiento independiente de Microduck documenta entornos basados en MuJoCo, un proceso de aprendizaje por refuerzo y políticas exportadas para el robot. Esa separación aclara las funciones: el software que mejora una política y el que ejecuta la política terminada son piezas distintas. El entrenamiento puede exigir mucho procesamiento aunque la política resultante sea lo bastante pequeña para ejecutarse en el ordenador a bordo del robot.
La inferencia utiliza el comportamiento aprendido
Durante la inferencia, el sistema introduce las observaciones actuales en un modelo entrenado y obtiene una salida. En una política de movimiento, esa salida ayuda a decidir la siguiente acción. El repositorio de ejecución de Microduck describe un bucle de control de 50 Hz que utiliza políticas neuronales para controlar los servos. Es información sobre la arquitectura publicada, no una medición independiente de Robots at Home. Explica por qué el robot puede responder continuamente sin volver a entrenarse en cada paso.
La inferencia puede utilizar hardware distinto al del entrenamiento y realizarse tanto en una simulación como en un robot físico. Cargar una política guardada en un escenario virtual suele formar parte de su evaluación. Un vídeo de esa evaluación puede parecerse mucho a una visualización del entrenamiento. Pregunta si los parámetros del modelo permanecen fijos y si el vídeo muestra un episodio de evaluación, una sesión de entrenamiento o una ejecución en hardware.
El suelo real no sigue el modelo
Un robot físico tiene mediciones imperfectas, fricción, retrasos y variaciones entre componentes. Una política que funciona en un escenario modelado con precisión puede fallar cuando cambian las condiciones. La documentación de Isaac Lab de NVIDIA presenta la aleatorización de dominio como una forma de mejorar la robustez: variar determinadas propiedades durante el entrenamiento para que el controlador se enfrente a más condiciones. Es una técnica para manejar la incertidumbre, no una garantía de cubrir todos los entornos reales posibles.
Antes de transferir una política, confirma que el hardware, las convenciones de las articulaciones, el formato de las observaciones y los límites de las acciones coinciden con lo que espera. Empieza por el procedimiento de ejecución documentado y una prueba controlada. Anota qué funcionó, qué falló y qué ajustes cambiaron. El resultado valioso es entender la relación entre simulación y hardware, incluidas las condiciones en las que el comportamiento sigue siendo fiable.
La programación es un punto de partida útil
Puedes aprender mucho sin entrenar una red neuronal. La guía inicial de Petoi pasa de las acciones integradas al control de articulaciones, las secuencias de órdenes y las habilidades personalizadas. Esas actividades enseñan la relación entre instrucciones y movimiento, y permiten comprender la calibración y los límites mecánicos. Una secuencia diseñada en una aplicación es un comportamiento programado; llamarla entrenamiento puede ocultar qué has modificado realmente.
Elige un primer experimento que puedas explicar en pocas frases. Ejecuta un ejemplo documentado, cambia un parámetro y observa la diferencia. Cuando pases al aprendizaje, identifica claramente en tus notas el simulador, la recompensa, la política y los pasos para ejecutarla. Así sabrás si una mejora procede de un modelo del mundo más preciso, de un controlador mejor o de una corrección en el montaje físico.